声対話型のAIエージェントを実際に運用してみると、回答の正確さだけでなく、応答までの間(ま)がユーザー体験を大きく左右することがわかります。
人間同士の会話では、相手が話し終わってから返答が始まるまでの時間が長いと、「聞こえていないのではないか」「会話が途切れてしまったのではないか」と不安を感じることがあります。特に、音声AIでは応答までのわずかな遅れが積み重なることで、機械と会話している印象が強くなってしまいます。
そのため、声対話型AIの開発では、回答の精度や自然さに加えて、どれだけ自然なタイミングで会話を始められるかが重要な設計ポイントになります。
音声AIの応答遅延は、大きく「音声認識(STT)」「AIによる推論(LLM)」「音声合成(TTS)」の3つの処理に分けて考えられます。このうち、推論がボトルネックとなる場合は少なく、実案件で計測した内訳は次のようなものでした。
このうち、実運用で見落とされやすいのが1番目の「音声区間の終了判定」です。
一般的には、無音状態が一定時間続いたことをもって発話終了と判断します。待ち時間を長く設定すれば、ユーザーが考えながら話している途中でAIが応答してしまう誤検知を減らせます。一方で、待ち時間が長すぎると、そのまま応答の遅延につながります。
つまり、単純に処理速度を上げるだけでなく、ユーザーが話し終えたタイミングをどれだけ適切に判断できるかが重要になります。
音声AIを構築する際には、どの音声エンジンやAPIを採用するかも重要です。現在は、音声認識・AI推論・音声合成を個別に組み合わせる方式に加え、音声入力から音声出力までを一つのモデルで処理するリアルタイム型のサービスも普及しています。
代表的な選択肢として、次のようなものがあります。
サービス・API | 主な特徴 | 適した用途 |
|---|---|---|
OpenAI Realtime API | 音声入力から音声出力までを直接処理。会話の割り込みやリアルタイムのツール利用にも対応 | 自然な対話や即時応答を重視するAIエージェント |
Google Gemini Live API | 音声・映像・テキストを組み合わせたリアルタイム対話に対応。多言語や割り込みにも対応 | 音声だけでなく映像や周辺状況も理解するAIエージェント |
Microsoft Azure Voice Live API | 音声対話に必要な機能を統合し、Azureの音声関連サービスと連携できる | 既存のAzure環境や企業システムとの連携を重視するケース |
Deepgram Voice Agent API | 音声認識・LLM・音声合成を組み合わせた音声エージェント構築に対応。処理ごとの遅延も把握しやすい | 各処理を管理しながら応答速度を最適化したいケース |
ElevenLabs Conversational AI | 自然な音声表現や音声合成に強み。音声認識や外部LLMとの組み合わせにも対応 | 人間らしい声や自然な話し方を重視するケース |
これらは単純に速度だけで優劣を決められるものではありません。例えば、OpenAI Realtime APIやGemini Live APIのような音声を直接扱う方式では、中間的なテキスト変換・再入力の工程を省略できるため、低遅延な会話を実現しやすくなります。
一方、DeepgramやElevenLabsなどを活用し、音声認識・推論・音声合成を組み合わせる方式では、それぞれのエンジンを個別に選択できるため、認識精度や音声品質、コストなどを細かく調整しやすいというメリットがあります。
重要なのは、特定のエンジンを選べば必ず最速になるわけではないということです。日本語の認識精度、専門用語への対応、音声の自然さ、割り込みへの対応、利用料金などを含め、実際の利用環境に合わせて比較する必要があります。
遅延を改善するには、処理そのものを高速化するだけでなく、待っている時間を待っていないように感じさせる設計も有効です。
その代表的な方法が「先読み」と「ストリーミング処理」です。
例えば、音声認識では、ユーザーが話している途中でも認識結果を逐次取得できます。この途中結果を利用してAIの推論を先に開始し、最終的に確定した認識結果と内容が一致していれば、そのまま処理を継続します。認識結果が変わった場合には、必要に応じて推論をやり直します。
また、音声合成でも、回答文全体が完成するまで待つ必要はありません。最初の一文や意味のまとまりができた時点で音声合成を開始し、生成された音声から順次再生することで、最初の応答が聞こえるまでの時間を短縮できます。
このように、各処理の完了を待ってから次の処理に進むのではなく、可能な部分を並行して進めることで、応答までの時間を短縮できます。
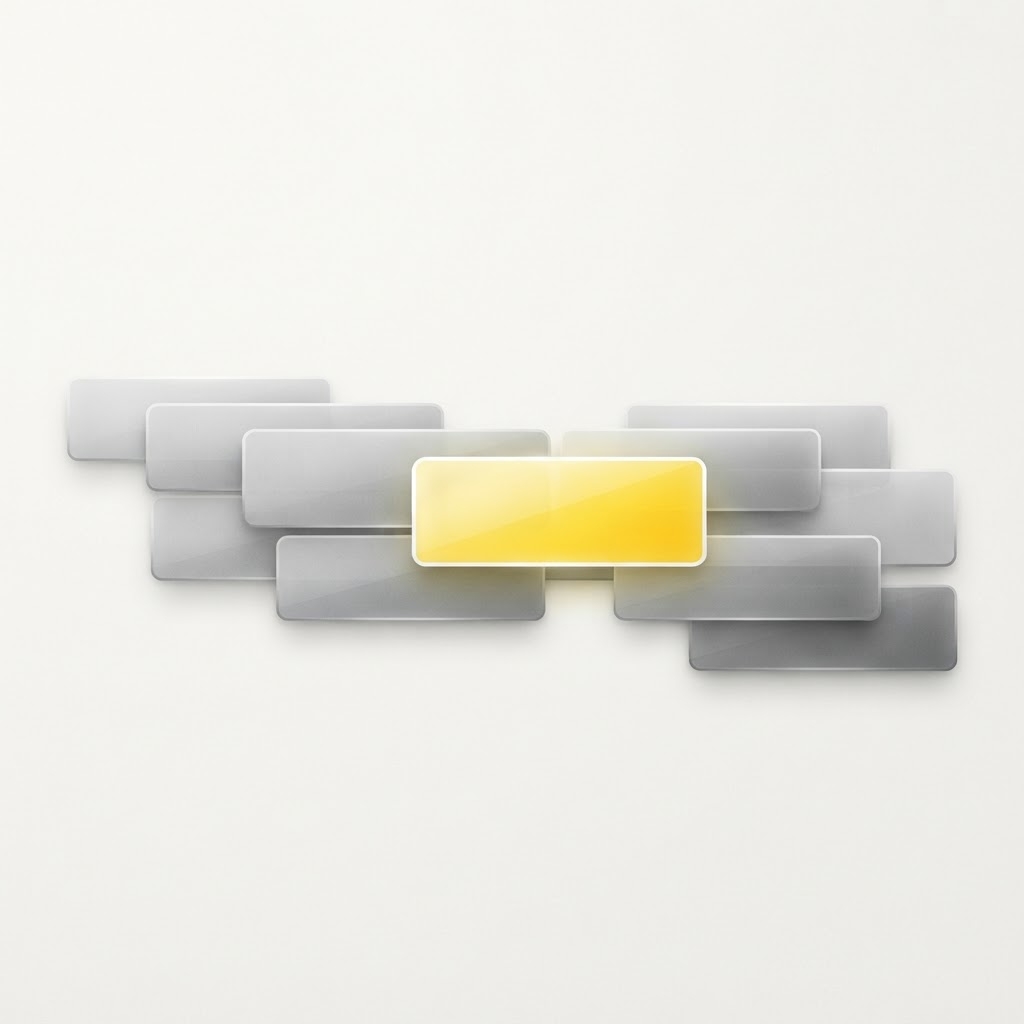
処理を逐次化した場合の時間軸イメージ。各処理の完了を待たず、重ねながら進めることで、ユーザーが体感する待ち時間を短縮します。
応答速度を改善するうえでは、単純な処理時間だけでなく、ユーザーがどのように感じるかを評価することも重要です。
例えば、ユーザーが少し考えながら話している途中でAIが応答を始めてしまうと、会話を遮られたように感じることがあります。逆に、ユーザーが話し終えているのにAIが長く沈黙すると、応答が止まってしまったような印象を与えます。
そのため、音声AIでは、発話終了の判定精度や応答開始までの時間に加え、ユーザーが話している途中でAIが割り込まないか、AIの応答中にユーザーが話し始めた場合に適切に停止できるか、といった点も検証する必要があります。
実案件では、処理方式や各工程の設定を見直すことで、応答時間を85%短縮したケースもありました。ただし、遅延をゼロに近づけることが常に正解とは限りません。相手が考えながら話す場面では、あえて少し間を置くほうが自然な会話になることもあります。
音声AIの開発では、最速で返答することではなく、ユーザーにとって心地よいタイミングで応答することが重要です。
利用するエンジンの特性を理解したうえで、処理方式や発話終了の判定、音声再生のタイミングを最適化することが、自然で使いやすい音声対話型AIエージェントの実現につながります。
オンライン30分。現状を伺い、AI活用の進め方をご提案します。検討段階のご相談も歓迎です。